
Lecture automatique TTS
Le contenu sonore du lecteur audio ci-dessous est une transcription vocale réalisée à l’aide du plugin SPEAKER (voir plus bas). Vous pouvez écouter cette même page avec un lecteur MEKS (cliquer ce lien).
Cette page présente mon choix d’un logiciel de lecture automatique — en anglais text-to-speech, d’où le sigle « TTS ».
J’ai installé ce dispositif pour faciliter l’accès de ce site aux personnes à vision réduite, mais aussi aux lectrices et lecteurs qui le fréquentent via une tablette ou un smartphone, plutôt qu’un ordinateur de bureau. Les statistiques révèlent que ce mode d’accès est celui de presque la moitié des visiteurs.
Avec un smartphone, surtout si l’on est occupé à d’autres activités — marcher, conduire un véhicule, faire la cuisine, etc. — il est difficile, si ce n’est impossible, de lire un long texte en entier. Or, de nombreuses personnes (c’est mon cas) sont habituées à l’écoute de podcasts d’émissions radiophoniques dont la durée peut dépasser une heure. Elles peuvent donc consacrer le même temps à écouter une transcription orale, pourvu que celle-ci ne soit pas trop artificielle…
De plus en plus fréquemment, des auteurs de blogs disposent au sommet de chaque article un lecteur audio qui permet d’en écouter le contenu. Toutefois, contrairement à eux, je n’ai pas du tout l’intention de m’enregistrer en train de lire mes écrits, ce qui m’obligerait à recommencer la lecture après chaque modification ! Ce site est en perpétuelle mise à jour, certainement une de ses principales qualités… J’ai donc choisi d’essayer la transcription orale automatique, le fameux TTS qu’on peut (re)lancer d’un simple clic après un travail d’édition.
J’avais une autre motivation à m’investir dans ce projet. Pendant une vingtaine d’années, j’ai travaillé au CNRS dans un centre de recherches en sciences de la parole — le Laboratoire Parole et Langage — et plus particulièrement avec l’équipe Prosodie de la parole dirigée par Daniel Hirst. À l’époque, nous rêvions de logiciels TTS qui synthétiseraient au mieux la voix humaine, autant dans ses dimensions phonétique et articulatoire que dans la construction de la prosodie : rythme, intensité, intonation. Les méthodes classiques « à partir de règles » ne donnaient satisfaction que dans des domaines limités. Or notre rêve est en partie devenu réalité — à vous d’en juger ! — grâce aux techniques d’apprentissage automatique qu’aujourd’hui les ingénieurs désignent par Big Data, et les « communicants » Artificial Intelligence…
En réalité, il n’y a aucune intelligence dans cette approche… On se contente de fabriquer des « boîtes noires » qui feront le travail, après un fastidieux entraînement sur de grandes masses de données. Mais ces boîtes noires ne peuvent pas — et ne pourront jamais — révéler leurs « secrets ». Pas plus qu’un enfant de cinq ans ne pourrait énoncer les règles auxquelles il obéit intuitivement pour communiquer dans sa langue maternelle.
Cette technologie a été rendue possible par l’arrivée de plateformes informatiques puissantes — en rapidité, en mémoire et en espace de stockage — et surtout par l’immense masse de données (textuelles et orales) collectées par les géants du Net (Google, Amazon, etc.). Des dispositifs text-to-speech sont aujourd’hui disponibles pour un grand nombre de langues, avec des voix de plus en plus proches de celles de locuteurs humains — voir la liste de Google et faire un essai.
J’ai donc décidé de tenter l’expérience, tout en gardant en tête l’idée que ce dispositif n’est pas supposé remplacer une lecture humaine, mais simplement offrir un nouveau mode d’accès au contenu de ce site. Le défi étant que, plus la transcription se rapproche de la lecture humaine, plus on en repère les défauts !
Le pari était risqué, mais il s’est avéré judicieux : en un mois, la fréquentation du site et le nombre d’articles consultés ont été multipliés par quatre.
Surtout, j’ai découvert qu’il était facile d’améliorer le rendu vocal des transcriptions en programmant des règles (voir ci-dessous). Retour, donc, à la vieille école des grammaires formelles ! 😀
Seule ombre au tableau : l’absence d’accents régionaux, ou plutôt la domination de celui des sujets dont les paroles ont été incluses au corpus d’apprentissage — voir article. Navré pour mes collègues sociolinguistes ! Le seul accent français « différent » sur Google Cloud est celui, uniformisé lui aussi, de locuteurs du « français canadien » (fr-CA). On constate d’ailleurs que, dans notre monde globalisé, la notion d’accent se réduit à la seule combinaison d’une langue et d’un pays…
La suite de cette page s’adresse aux éditeurs de sites WordPress francophones qui souhaitent se lancer dans la même aventure. J’y partage mon expérience afin de leur faciliter la tâche.
Premiers essais de plugins TTS
J’avais pris connaissance de quelques logiciels TTS sur des articles comparatifs (en anglais). Leurs descriptions en étaient malheureusement superficielles, visiblement rédigées par des informaticiens qui n’avaient pas pris le temps de les évaluer sur des données réelles.
Il faut savoir que la transcription orale, proprement dite, est presque toujours effectuée sur les grandes plateformes : Google Cloud, Amazon Web Services, Microsoft Azure, et peut-être d’autres. Le résultat sera donc quasiment identique quel que soit le plugin installé sur le site WordPress. Seuls quatre critères permettent d’exercer un choix adapté aux besoins (et au budget) :
- Le prix du plugin
- L’interface d’édition
- L’interface du lecteur audio
- Le pré-traitement des données textuelles
Je ne décrirai que des plugins couplés à Google Cloud. La bonne nouvelle est que la transcription orale via Google Cloud est gratuite dans des quantités raisonnables — voir tarif. Avec un simple compte Google Cloud, on peut transcrire chaque mois, sans rien dépenser, un nombre appréciable de caractères.
J’utilise de préférence les voix les plus raffinées : celles des catégories « Neural2″ et « Wavenet », pour lesquelles la plateforme traite gratuitement jusqu’à 1 million de caractères par mois. Au-delà de ce quota, compter 16 dollars par tranche supplémentaire de 1 million de caractères. Ce surcoût est quatre fois moins élevé pour les voix standard, mais leur rendu sonore (en français) est franchement moins bon. Les tarifs sont quasiment identiques sur Amazon Polly.
Les plateformes proposent aussi, moyennant finances, de créer une brand voice, autrement dit une voix ayant toutes les caractéristiques d’une voix existante prise pour modèle. Il est à craindre que les imperfections soient encore plus audibles dans ce cas !
Quelle que soit la voix choisie, le contour prosodique est médiocre sur les phrases très longues. Il peut même conduire à un escamotage de syllabes, voire une prononciation incompréhensible si l’on s’obstine à faire de trop longues phrases. Utiliser une ponctuation abondante : ne pas économiser les virgules, ne pas essayer de lire du Proust ! 😀
Le véritable critère à prendre en compte pour la viabilité d’un TTS est le prix du plugin. Soit le vendeur demande un règlement une fois pour toutes, soit il faut passer par un abonnement mensuel ou annuel, auquel cas le plugin peut aussi limiter le nombre de textes ou de caractères transcrits.
Pour ne pas vous faire plus attendre, je peux révéler que j’ai dépensé, en tout et pour tout, 29 euros pour la mise en place du plugin SPEAKER sur ce site (en décembre 2022). Bien entendu, la facture de Google Cloud est en proportion du volume de texte converti, étant donnés les innombrables essais qu’il m’a fallu faire pour en affiner les règles… Il est donc prudent, surtout au début, de garder un œil sur la facturation (billing) de son compte Google Cloud.
Voici pour commencer les deux plugins que j’ai essayés en situation réelle, mais pas adoptés. Ils peuvent s’avérer préférentiels dans d’autres environnements.
Trinity Audio
Ce plugin (voir téléchargement) fonctionne en version gratuite, mais avec une contrainte sévère sur le nombre d’articles ou pages converties chaque mois : seulement 5 (voir les prix des différentes offres). Cette version gratuite ne sert pratiquement qu’à titre d’essai.
Je suis donc immédiatement passé à l’offre BASIC facturée 15 dollars par mois. Mauvaise surprise : l’interface (fin 2022) ne permettait pas un versement mensuel. J’ai donc dû m’acquitter de 189 dollars pour un abonnement annuel. Somme qui m’a heureusement été remboursée sans difficulté quand j’ai renoncé à cette solution — par application de la garantie de remboursement à 30 jours.
Avec l’offre BASIC, j’ai pu convertir un plus grand nombre d’articles, la limite étant de 30 par mois. Toutefois, après 5 modifications, toute modification de l’article est comptée comme un nouvel article. Autrement dit, pour un même article sur lequel j’avais effectué 9 modifications, j’étais taxé de « 5 articles ». On comprend ici que même l’offre BASIC ne convient pas aux sites dont les contenus sont régulièrement mis à jour. Chaque fois que je relis un de mes textes, j’ai tendance à en corriger le contenu — car je suis un médiocre rédacteur. Pour un bon rendu sonore, des corrections significatives peuvent se limiter à ajouter une virgule à un endroit particulier, afin de délimiter les unités de souffle qui gouvernent le contour prosodique.
L’offre BASIC donne accès à un autre dispositif appelé « lexique » (lexicon). Ce sont de simples règles de réécriture appliquées à des mots ou des expressions. Un très grand avantage du lexique de Trinity Audio est la possibilité d’entrer des caractères phonétiques (alphabet IPA) et d’affiner ainsi la prononciation de mots étrangers sans changer de langue. Toutefois, ce lexique étant limité à 5 mots sur l’offre BASIC, ce n’est rien d’autre qu’un produit d’appel pour l’offre (appelée STANDARD) qui coûte 849 dollars par an… À ce prix, l’utilisation du lexique est illimitée, mais la contrainte reste de 200 articles (ou modifications) par mois.

Un avantage de Trinity Audio sur les autres solutions décrites ci-dessous est le design de son lecteur — voir image ci-dessus. Il comprend (en haut à droite) deux boutons qui permettent d’avancer ou de reculer de 10 secondes. D’autre part, on peut en option ajouter un lecteur « flottant » qui reste positionné dans la marge gauche de la page, même pendant son défilement. Cette solution est idéale pour la lecture sur les petits écrans des smartphones, et globalement bien adaptée à une lecture de texte (plutôt qu’une écoute musicale).
Noter aussi, en haut à droite (à peine visible) un bouton qui permet le choix de la vitesse de lecture. Cette fonction très utile existe sur tous les dispositifs TTS.
Par contre, le positionnement sur la page du lecteur audio n’est pas facile : soit au sommet, soit au bas de l’article, soit encore l’option d’un lecteur javascript qui nécessite de copier un code dans les champs personnalisés (customized fields) de l’article, puis de placer un shortcode dans un bloc HTML à l’emplacement du lecteur. Sur un site WordPress, cette solution ne fonctionne qu’avec une extension (par exemple Code Embed) permettant d’insérer du javascript dans le contenu textuel des articles… Tout cela est laborieux à mettre en œuvre, et peut-être même une porte ouverte à des failles de sécurité.
Nonobstant les limitations que j’ai exposées, Trinity Audio est une bonne solution si le budget l’autorise. J’ai longuement dialogué avec leur équipe technique qui s’est montrée aussi efficace que bienveillante, m’autorisant même des dépassements de quotas pour effectuer des essais. Localisée en Ukraine, cette équipe mérite d’être soutenue pour la poursuite de ses activités dans des conditions particulièrement difficiles.
BeyondWords
Cette solution (voir téléchargement) se présente sous trois tarifs : le plan PILOT (gratuit), le plan PRO (89 dollars par mois) et le plan ENTERPRISE (tarif non précisé). Je n’ai essayé que la version gratuite qui autorise 10 000 caractères par mois, ce qui peut paraître limité, sauf que les modifications ne sont pas déduites du quota tant que le nombre de paragraphes de l’article n’est pas augmenté. Ce plan gratuit est donc viable sous réserve de désactiver la mise à jour automatique de la conversion pendant qu’on édite le texte.
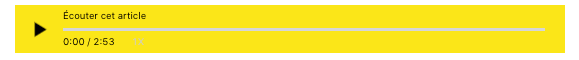
Le lecteur audio (voir image ci-dessus) est très facile à positionner n’importe où sur la page. Il peut être largement modifié en utilisant les codes CSS. (Je l’avais ici colorié en jaune.) Un point qui me paraît intéressant est sa très faible hauteur. Il comprend aussi (à peine visible, en bas à gauche) un bouton pour le choix de la vitesse de lecture.
Dès la solution gratuite, BeyondWords donne accès à une sorte de lexique (aliases) illimité. Par exemple, j’ai programmé le remplacement automatique de « et al » par « et collègues », car c’est ainsi qu’un lecteur averti interprèterait cette expression. Par contre, ces alias ne reconnaissent pas l’alphabet phonétique. Pour prononcer « American Stroke Association », par exemple, il faut bricoler un alias du style « American Stroke Associeysheun » au lieu de « əˈmɛrəkən stroʊk əˌsoʊsiˈeɪʃən » en IPA (voir le convertisseur)…
On peut, par défaut, choisir une voix pour lire les titres et une autre pour les paragraphes ordinaires. Toutes ces voix sont désignées par des prénoms.
Une option caractéristique de BeyondWords consiste à désolidariser (désynchroniser) le texte d’origine de celui qui doit être lu, ce qui permet des corrections de prononciation (en plus de celles des alias) mais aussi l’édition d’un texte lu aussi différent qu’on le souhaite du texte écrit. C’est actuellement le seul moyen, en français, de corriger les liaisons. Bien entendu, toute modification du texte écrit devra être reproduite (manuellement) sur le texte lu.
Le nombre de voix (et de langues) est impressionnant, puisque ce logiciel permet d’accéder aux ressources des trois plateformes Google Cloud, Amazon Web Services, Microsoft Azure, ainsi qu’à des voix (uniquement en anglais) spécifiquement développées par BeyondWords.
J’ai correspondu avec l’équipe très sympathique de BeyondWords pour leur suggérer quelques corrections et améliorations. Ils m’ont notamment signalé qu’ils allaient réviser le design de leur lecteur audio pour répondre à des besoins tels que la version « flottante » que j’avais beaucoup appréciée sur Trinity Audio.
L’équipe de BeyondWords comprend des ingénieurs et des linguistes informaticiens de Google, d’Apple et du Centre de recherche sur les technologies de la parole d’Edimbourg au Royaume-Uni.
Même dans sa version gratuite, BeyondWords est une solution qui permet d’obtenir un bon rendu vocal sans faire appel à des manipulations informatiques complexes. Cependant, comme Trinity Audio, elle n’est optimisée que pour la publication et la transcription orale de textes qui ne sont pas destinés à recevoir de fréquentes modifications.
Remarque
Je n’ai pas conservé les installations de Trinity Audio et BeyondWords, ce qui fait que certains aménagements que j’ai effectués sur SPEAKER (voir ci-dessous) auraient pu aussi résoudre quelques problèmes sur ces solutions. Merci de me faire part de votre expérience !
SPEAKER
Ma motivation principale pour essayer (puis adopter) SPEAKER — voir téléchargement et description détaillée en anglais — était que c’est le seul dispositif à ce jour (début 2023) qui gère (une partie du) balisage SSML (Speech Synthesis Markup Language). Le codage de ces balises par SPEAKER est (incomplètement) présenté sur cette page.
Plateforme de conversion TTS
SPEAKER utilise la plateforme Google Cloud pour créer les fichiers audio. À l’inverse de ses concurrents, il n’impose aucune limitation au nombre de textes convertis. Concrètement, l’utilisateur (le webmaster) doit utiliser son propre compte Google Cloud et s’acquitter directement sur ce compte, le cas échéant, des frais de dépassement du quota mensuel.
L’installation de SPEAKER nécessite le règlement, une fois pour toutes, d’un droit d’utilisation (29 euros fin 2022) à la société CodeCanyon. C’est donc de loin la solution la plus économique, et probablement — nous allons le montrer — la plus puissante pour un informaticien.
La partie laborieuse de cette installation est la mise en connexion du plugin SPEAKER avec le compte Google Cloud qui sera utilisé pour les conversions. Les habitués de Google s’y retrouveront mieux que moi ! Tout est documenté en détail — en anglais, ça commence ici et ça continue ici.
Le traitement
Schématiquement, le traitement se résume ainsi : quand on clique le bouton Create audio (ou Re-create audio), SPEAKER lit le contenu de la page ou de l’article tels qu’ils apparaissent à l’affichage — détail important, comme nous le verrons ci-dessous.
SPEAKER applique ensuite des règles de réécriture (voir ci-dessous) programmées (en option) par l’utilisateur. Il découpe enfin le texte en fragments (maximum 4500 caractères) envoyés à Google Cloud pour la conversion sonore. Cette taille un peu supérieure à 4500 caractères est une limite incontournable du service Google Cloud.
Les fichiers sonores (au format MP3) retournés par Google sont alors stockés dans un répertoire approprié. En fin de conversion, le plugin colle ensemble ces fichiers temporaires pour fabriquer un seul fichier MP3 qui sera utilisé à l’audition.
Stockage des fichiers sonores
Plusieurs options sont proposées pour le stockage des fichiers MP3 : soit dans un répertoire du site WordPress /wp-content/uploads/speaker/, soit dans un espace de Google Cloud. La seconde solution (que je n’ai pas su implémenter) peut entraîner une facturation supplémentaire. Elle a peut-être comme avantage un accès plus rapide aux fichiers lors de la lecture (à vérifier).
Lorsqu’on opte pour l’hébergement des fichiers MP3 sur le site WordPress, on peut demander d’afficher les fichiers sonores dans le dossier « médias », ce qui peut être utile si l’on utilise un plugin différent pour afficher le lecteur audio — bien que la construction de ces URL soit très facile.
Dans tous les cas, aucun service n’est facturé pour la lecture des fichiers sonores. Cette lecture n’implique pas Google Cloud. Autrement dit, le prix de la sonorisation du site ne dépend pas de sa fréquentation. C’est un point à vérifier avant de se lancer dans toute autre solution.
Les lecteurs audio
Le positionnement du lecteur n’importe où sur la page (avec l’option de design « shortcode ») est simple, puisqu’il se résume à inscrire le shortcode [@speaker] dans un bloc HTML personnalisé (sous WordPress). Supprimer le caractère ‘@’ utilisé ici pour empêcher l’affichage du lecteur sur cette page…
➡ Je n’ai pas essayé les options de position « before title », « top fixed » etc. car en sélectionnant « before title » le site s’est bloqué (error 503), ce qui m’a obligé à désactiver brutalement SPEAKER via un accès FTP !
Plusieurs options sont proposées pour le design du lecteur audio : soit un lecteur Chrome, soit le lecteur spécifique du navigateur, soit le lecteur par défaut de WordPress, soit enfin des lecteurs « rond », « arrondi » ou « rectangulaire ». On peut ensuite en améliorer l’aspect en jouant sur les classes CSS, et insérer du code HTML avant ou après le lecteur. Le lecteur Chrome est celui qui apparaît en haut de cette page, quel que soit votre navigateur.
Dans le shortcode, on peut utiliser une syntaxe plus complète : [@speaker id=nnnn] (toujours sans le caractère ‘@’) dans laquelle « nnnn » est le numéro de la page ou de l’article concerné. Ce qui permet d’afficher sur une page un lecteur lisant le texte d’une page différente. Très pratique si l’on envisage d’éditer un texte pour la lecture distinct de sa version écrite, comme avec BeyondWords. Dans ce cas, le texte destiné à la lecture pourra être édité sur une page privée, invisible sur le site, et rendue publique uniquement le temps de générer sa transcription orale. Cette solution est meilleure que celle précédemment mentionnée pour BeyondWords, car elle ne repose que sur des ressources (textuelles et sonores) locales.
Rien n’interdit d’éditer par la suite le fichier sonore en lui ajoutant, par exemple, de la musique.
De manière générale, si les fichiers sont stockés dans le répertoire /wp-content/uploads/speaker/, un simple lien suffit pour accéder au contenu sonore. Par exemple, le lien https://lebonheurestpossible.org/wp-content/uploads/speaker/post-35807.mp3 permet d’écouter la transcription de cette page (identifiant 35807). Ce même lien permet d’insérer un lecteur audio standard HTML 5 donnant le même accès :
De plus, il est possible d’utiliser des lecteurs plus sophistiqués, générés par des plugins de WordPress, puisque le seul paramètre à introduire est l’URL du fichier sonore, facile à déterminer pour n’importe quel article ou page. J’ai trouvé (et adopté) un lecteur « collant » (sticky) avec l’extension gratuite Meks Audio Player (voir téléchargement) qui se positionne automatiquement au bas de la fenêtre. Dans ce cas, les lecteurs SPEAKER peuvent être supprimés. Voir par exemple un article de ce site, ou écouter cette page avec le lecteur MEKS.
On appréciera que le lecteur MEKS autorise des sauts en avant, et en arrière, de 15 secondes, comme c’était le cas de celui de Trinity Audio. Ses seuls défauts actuels sont sa hauteur excessive, et le nombre réduit de paramètres permettant de modifier son aspect.
Pré-traitement du texte
Des shortcodes sont proposés par SPEAKER pour rendre inaudibles certains passages du texte, comme par exemple des légendes de figures ou des références bibliographiques en fin d’article. Les mêmes effets peuvent être produits, et donc automatisés, par les règles de réécriture.
SPEAKER n’utilise pas un lexique ni des alias, mais il permet d’introduire un nombre illimité de règles (RegEx replacements) obéissant à une syntaxe (expressions régulières) que les programmeurs utilisent couramment dans des fonctions comme preg_replace() du langage de programmation PHP, ou encore pour gérer la redirection de connexions dans les fichiers htaccess des serveurs HTTP Apache.
L’utilisation efficace de SPEAKER exige donc une parfaite maîtrise de la syntaxe des expressions régulières. Il suffit qu’une règle soit mal formée pour que la conversion échoue, avec une redoutable alerte : « error 3 » !
Par exemple, les voix francophones de SPEAKER prononcent incorrectement le nom de « Jeanne Calment » en disant « Calmin ». Pour corriger ce défaut, on peut introduire la règle suivante :
/Calment/
calmant
Un mot, ou une suite de mots, peuvent aussi être reconnus et remplacés par d’autres suites de mots, par exemple :
/TLF/
dictionnaire « trésor de la langue française »

/整体/
terme japonais

/\s=>\s/
 implique
Des règles plus complexes et leurs astuces techniques sont expliquées ci-dessous.
Traitement par lot
Le traitement par lot (en anglais batch processing) est une fonction très puissante de SPEAKER. Une fois que les règles de réécriture ont été complétées et corrigées, il peut être nécessaire de relancer la conversion de tous les articles (ou d’une sélection d’articles) du site, sans devoir les ouvrir un par un en mode édition…
Pour cela, il suffit d’afficher la liste des pages ou articles, de sélectionner lesquels doivent être traités, puis de sélectionner « Create audio » dans « Actions groupées ».
➡ Attention toutefois au risque d’explosion de la facture Google Cloud ! Pour cette raison, les transcriptions vocales de ce site ne sont pas toutes mises à jour après chaque modification des règles ou des paramètres.
Gabarits (templates)
Les gabarits (templates) servent, dans SPEAKER, à exploiter les Custom Post Types des récentes versions de WordPress. Ce développement est en accord avec les plus récentes méthodes de construction des sites. Suivre les instructions de cette page.
Une équipe très sympa
J’entretiens une correspondance régulière avec l’équipe technique de SPEAKER — elle aussi localisée à Kiev — tantôt via leur forum d’entraide, tantôt par messagerie électronique.
J’ai modifié leur plugin (versions 3.4.2 à 4.0.13) pour contourner quelques problèmes expliqués ci-dessous, puis je leur ai envoyé une liste de suggestions (voir copie). Leurs réponses ont été cordiales et constructives, parfois avec quelques jours de retard, étant donnée la situation.
Je suis sur le point d’installer la version suivante (4.0.4) et mettrai à jour cette page en conséquence.
Pour les geeks…
Ce qui suit est destiné aux webmasters souhaitant installer la solution SPEAKER sur un site WordPress francophone. Loin de couvrir toutes les options, je m’en tiens aux points dont la compréhension m’a demandé quelques journées de travail, en l’absence d’une documentation détaillée.
Les lecteurs anglophones habitués à l’informatique peuvent consulter le rapport que j’ai fait parvenir à l’équipe technique en janvier 2023. En fin de rapport, les annonces encourageantes de l’équipe.
Choix d’une voix ou d’une langue
Sur SPEAKER, on choisit une voix et une langue par défaut. Il est ensuite possible d’en changer au cours de l’article ou de la page, en utilisant des instructions SSML (voir ci-dessous). Voir, par exemple, un changement de voix dans l’article Mon magnifique mari.
En français, surtout pour les voix masculines, il est préférable d’utiliser celles de la série Neural2 , ou en second choix Wavenet. Pour des raisons inexpliquées, la transcription vocale d’un texte avec une voix Neural2 peut échouer (« error 3 »). Dans ce cas, il suffit de se rabattre sur une voix Wavenet. Dans ce cas, je préfère une voix féminine.
Les voix que j’ai adoptées en standard sur ce site sont :
- Voix par défaut (masculine) : fr-FR-Neural2‑D réglée à la vitesse 1.2
- Citations (féminine) : fr-FR-Wavenet‑C à vitesse normale
- Voix lorsque « error 3 » (féminine) : fr-FR-Wavenet‑E
- Voix lorsque « error 3 » (masculine) : fr-FR-Wavenet‑D
Les voix en d’autres langues sont listées ci-dessous.
Bien entendu, ces choix pourront être révisés lorsque de nouvelles voix seront disponibles sur Google Cloud.
Pour chaque voix, on peut choisir un Audio Profile qui permet d’optimiser le rendu en fonction des conditions d’écoute : montre connectée, téléphone portable, casque audio, petit haut-parleur, grand haut-parleur, chaîne HiFi, haut-parleur d’automobile, interactive voice response (?). J’ai opté pour « téléphone portable » sur ce site.
Positionnement du lecteur audio SPEAKER
Le thème utilisé sur le présent site impose quelques contraintes si l’on utilise un lecteur audio (player) positionné dans le texte, comme c’est le cas avec celui de SPEAKER. Notamment, pour que l’image mise en exergue soit correctement positionnée sur la plupart des articles, on ne doit pas disposer le lecteur audio plus haut qu’un certain nombre de paragraphes. Par contre, le lecteur pour smartphone doit être placé le plus haut possible, mais toujours après le deuxième paragraphe.
Des lecteurs « flottants » comme celui de Trinity Audio, ou « collants » (sticky) comme celui de MEKS, sont donc bien mieux adaptés à la lecture sur smartphone. Ce qui suit ne concerne que les lecteurs positionnés dans le texte.
Pour assurer un positionnement distinct de deux lecteurs, il suffit d’utiliser des classes CSS, par exemple :
.desktop {
	display: initial;
	}
.mobile {
	display: none;
	}

@media only screen and (hover: none) and (pointer: coarse) {
.desktop {
	display: none !important;
	}
.mobile {
	display: initial !important;
	}
}
Puis on inscrit chaque lecteur dans un « div » attaché à la classe correspondants, par exemple :
<div class="desktop">[@speaker]</div>

<div class="mobile">[@speaker]</div>

(Supprimer les caractères ‘@’)
Utilisation de wp-Typography
Cet excellent correcteur de typographie (voir téléchargement) produit des codes qui affectent à plusieurs niveaux le fonctionnement de SPEAKER (version 4.0.13).
En premier lieu, l’affichage du lecteur : le correcteur remplace les guillemets droits par des guillemets typographiques, il ajoute des espaces insécables avant certains signes de ponctuation, et il insère des symboles invisibles de césure (soft hyphens) qui brouillent le code.
En ce qui concerne l’affichage des lecteurs, une solution efficace consiste à exclure la classe CSS « mdp-speaker-wrapper » du traitement par wp-Typography. Pour cela, dans les réglages généraux de wp-Typography, inscrire « mdp-speaker-wrapper » dans le champ Ignorer les classes CSS.
D’autres problèmes liés à wp-Typography conditionnent la programmation des règles de réécriture — voir ci-dessous.
Suivi du processus
J’ai souvent été confronté à l’impression désagréable que des règles de réécriture (RegEx replacements) ne fonctionnaient pas, ou encore que la transcription orale échouait pour une raison inconnue.
Il est possible de suivre globalement la processus en se connectant sous FTP au répertoire /wp-content/uploads/speaker/. Pendant la transformation, on voit apparaître les fichiers MP3 en provenance de Google Cloud, par exemple :
tmp-f6g4ssr3q-post-35807.mp3
tmp-qz9j23mnk-post-35807.mp3
etc.
pour un article ou une page dont l’identifiant serait « 35807 ».
Si le processus arrive à son terme, ces fichiers temporaires disparaissent et sont remplacés par un unique fichier : post-35807.mp3.
Ce qui est invisible, c’est la séquence de textes envoyés à Google Cloud ainsi que, en amont, les textes juste après leur transformation par les règles de réécriture. J’ai donc ajouté des instructions dans SpeakerCaster.php pour créer un fichier post-35807.html qui contient ces fragments de textes. Suivre cc lien pour afficher la trace de la transcription vocale de cette page :
https://lebonheurestpossible.org/wp-content/uploads/speaker/post-35807.html
Une autre instruction détruit tous les tmp-*.* avant le lancement d’une nouvelle conversion.
Cette trace m’a permis en premier lieu de vérifier les réécritures. Par exemple, de m’apercevoir que la règle (voir ci-dessus) corrigeant la prononciation de « Calment » n’était jamais appliquée. La raison est que le mot soumis aux règles de réécriture n’était pas « Calment » mais « Cal­ ;ment », car il a été coupé par un soft hyphen. La règle était donc devenue :
/Cal.{0,5}ment/
calmant
Il faut bien connaître les expressions régulières pour comprendre que « .{0,5} » représente une séquence arbitraire de caractères de longueur 0 à 5, couvrant les deux cas : avec ou sans « ­ ; ».
Cette solution est un très mauvais bricolage, car la séquence « .{0,5} » peut contenir n’importe quoi. Je montre plus loin comment éliminer les soft hyphens une fois pour toutes.
De manière générale, l’intérêt du fichier post-*.html est de faire apparaître le texte tel qu’il sera interprété par le convertisseur text-to-speech.
Si le processus s’arrête — ce qui est généralement signalé par une énigmatique « erreur 3 » — on peut voir à la fin de ce fichier quel fragment de texte a provoqué cette erreur, et souvent la corriger.
Erreur 503
Le plugin émet une énigmatique alerte « error 503 » après environ une minute de traitement. Celle-ci apparaît sur des textes relativement longs mais ne correspond à rien de significatif : le processus continue même si on ne clique pas le bouton « OK ». Je l’ai donc signalée comme un bug.
Time-out
Comme indiqué dans ma note, il semble que la session d’échanges entre le site (via SPEAKER) et Google Cloud soit limitée à environ 3 minutes. Pour cette raison, le processus n’est pas achevé si les fichiers MP3 sont trop nombreux. J’ai demandé aux techniciens que cet échec soit, au minimum, signalé à l’utilisateur, et suggéré de lancer d’autres sessions jusqu’à la conversion intégrale du texte.
Il arrive même que le plugin fusionne les fichiers tmp-*-post-*.mp3 alors que la liste est incomplète, Google Cloud ayant abandonné la partie. Dans ce cas, le fichier post-*.mp3 ne couvre pas la totalité du texte. On s’en aperçoit en surveillant sous FTP le répertoire /wp-content/uploads/speaker/, mais il serait utile que cette erreur soit rendue visible sur l’interface — il suffirait pour cela de détecter la présence de fichiers tmp-*-post-*.mp3.
Parfois, il suffit de relancer la conversion pour que le time-out ne se produise pas. Un facteur influant sur le résultat est donc certainement la vitesse des connexions et la disponibilité des serveurs.
➡ Actuellement, le time-out empêche la transcription vocale d’articles particulièrement longs sur ce site.
Utilisation du SSML
C’est un vaste sujet. La documentation de SPEAKER (voir page) est incomplète, et celle décrivant le SSML (voir page) couvre des cas qui ne sont pas pris en charge dans SPEAKER.
Prenons comme exemple l’insertion de pauses pour laquelle SPEAKER fournit un opcode qui peut être placé (mais reste invisible) sur la page WordPress, par exemple :
[@speaker-break time="2s" strength="none"]
(Supprimer le caractère ‘@’)
Ce format opcode fonctionne, mais il ne peut pas être utilisé dans une règle de réécriture (RegEx replacement). La raison est que SPEAKER interprète ses opcodes avant d’appliquer les règles. La documentation ne fournit pas l’expression, après interprétation, qui est un pur tag SSML :
<break time="2s" strength="none"></break>
Il n’est pas utile de commenter ici le paramètre « strength » qui agit sur le contour prosodique.
La règle générale concernant SSML est donc que tout opcode utilisé par SPEAKER est transformé en une expression de syntaxe SSML, que le TTS de Google Cloud est capable de traiter. Plutôt qu’un opcode, on peut donc entrer directement cette expression sur la page web, mais il faut en tout cas le faire chaque fois qu’on utilise une règle de réécriture.
Les pauses permettent de corriger le rythme de la phrase, mais aussi d’empêcher une liaison mal-t‑à propos. Par exemple, cette règle interdira à Google Cloud de dire « un naricot » ou « les zaricots » :
/(haricots?)/
<break time=".05s" strength="none"></break> $1
Les parenthèses (en rouge) servent à capturer le mot, avec ou sans “s”, qui est reproduit dans la variable « $1 ». La pause de 50 millisecondes insérée avant « haricot » est inaudible, mais elle empêche le TTS de faire la liaison. Il est possible qu’une voix Google Cloud bien entraînée (à parler de haricots) ne fasse pas cette mauvaise liaison, mais la règle apporte une précaution supplémentaire, qui s’avère nécessaire avec des mots inhabituels.
Une autre fonction TTS très utile est le changement de voix et/ou de langue. Je l’ai automatisée, sur ce site, pour changer de voix à la lecture de citations (voir ci-dessous). Un opcode de changement de voix est par exemple :
[@speaker-voice name="en-GB-Wavenet-A"] Hello! [/speaker-voice]
(Supprimer le caractère ‘@’)
Il se traduit ainsi en SSML :
<voice name="en-GB-Wavenet-A"> Hello! </voice>
C’est sous cette dernière forme qu’on l’utilise dans une règle de réécriture.
La fonction « say-as » est très utile pour faire dire les dates en entier. Voici par exemple un opcode qui fera dire « deux février deux-mille vingt-trois » au lieu de « deux sur zéro deux sur deux-mille vingt-trois » :
[@speaker-say‑as interpret-as="date" format="ddmmyyyy" detail="1"] 2/02/2023 [/speaker-say‑as]
(Supprimer le caractère ‘@’)
Ce format accepte que les jours et les mois soient indiqués par un seul chiffre. Il accepte d’autre part divers séparateurs : « / », « – », etc.
On peut programmer une règle pour que toute expression ressemblant à une date en français soit lue (dans la langue choisie) comme une date :
/([0-9]{1,2})\/([0-9]{1,2})\/([0-9]{4})\)\.?/
<say-as interpret-as="date" format="ddmmyyyy">$1/$2/$3</say-as>
Pour les novices des expressions régulières, « [0–9]{1,2} » représente une suite de 1 ou 2 chiffres. Les parenthèses (en rouge) sur la première ligne servent à capturer les expressions qui sont ensuite affectées aux variables $1, $2 et $3.
Une fonction SSML qui n’est actuellement pas gérée par SPEAKER est la phonétique (selon l’alphabet IPA). Par exemple, l’expression :
Le <phoneme alphabet="ipa" ph="ˈhændbʊk ɒv njuːˈtrɪʃᵊnᵊl ˈvæljuː ɒv fuːdz ɪn ˈkɒmən ˈjuːnɪts">Handbook of Nutritional Value of Foods in Common Units</phoneme>
est simplement transcrite comme « Le Handbook of Nutritional Value of Foods in Common Units » qui est bien sûr mal prononcé par le TTS francophone. On peut ici contourner le problème en changeant de voix/langue :
Le <voice name="en-GB-Wavenet-A"> Handbook of Nutritional Value of Foods in Common Units </voice>
Cela sonne très chic, mais les changements de voix/langue peuvent poser d’autres problèmes, voir ci-dessous.
Programmation des règles de réécriture
Si vous n’êtes pas habitué·e à la syntaxe ésotérique (bien que parfaitement logique) des expressions régulières, vous en serez devenu expert·e une fois achevé le bon réglage d’un TTS en français ! 😀
Dans l’interface de SPEAKER, les règles (RegEx replacements) s’écrivent sur deux lignes. L’oubli ou l’ajout d’une ligne (même vide) fait échouer totalement le processus, bien souvent sans que vous en soyez averti·e. Même désastre si une seule règle contient la moindre erreur de syntaxe… Il serait bienvenu de disposer d’un vérificateur de syntaxe de l’ensemble des règles dans un script PHP séparé ou sur un service en ligne, when time permits !
Voici, pour commencer, une règle qui détecte le début du texte (le symbole « ^ ») afin d’insérer une phrase au début de la lecture :
/^/
Bonjour ! Cette transcription vocale a été réalisée automatiquement. Merci de m'en signaler les erreurs de prononciation ! <break time="1s" strength="none"></break>
Attention : ce sont seulement deux lignes. On reconnaît l’utilisation d’une pause de 1 seconde, en fin de phrase, pour la séparer de la lecture proprement dite.
De nombreuses règles servent à lire une abréviation, comme le ferait un lecteur bien éduqué. Par exemple, l’expression « et al. » devrait être lue « et collègues ». Voici la règle :
/([^A-Z^a-z])et\s+al\./
$1et collègues
On déclare sur la première ligne que « et » ne doit pas être précédé d’une autre lettre (« [^A‑Z^a‑z] ») et qu’il doit être suivi d’au moins une espace (« \s+ »). Le point de « al. » est représenté précédé d’un caractère d’échappement : « \. ». Le caractère non-alphabétique capturé entre les parenthèses (en rouge) est reproduit par la variable $1.
Pour les informaticiens : la règle qui précède est exécutée par SPEAKER en appelant la fonction preg_replace() en PHP :
$text = preg_replace("/([^A-Z^a-z])et\s+al\./", "$1et collègues", $text);
Voici d’autres exemples de règles :
/([^A-Z^a-z])[Ee]\.g\.\s/
$1par exemple
pour interpréter « e.g. » ou « E.g. » = exempli gratia. L’expression « [Ee] » reconnaît « E » ou « e ». Cette règle ne fonctionne pas si une espace est présente, comme dans « e. g. ».
/TLF[Ii]?/
dictionnaire « Trésor de la langue française »

/([^A-Z^a-z])M\.D\./
$1docteur en médecine
Ne pas oublier le « $1 » au début, qui a capturé le caractère précédant « M », quel qu’il soit…
/整体/u
terme japonais
Ici, on ne demande pas au TTS de lire le mot « seitai » en japonais, car il est déjà dit dans la phrase « … le seitai (整体)… », mais simplement de préciser que c’est un terme japonais. Noter l’option « /u » qui veut dire que la cible doit être lue comme de l’Unicode. Il est prudent d’ajouter cette option « /u » à toutes les règles.
Et, pourquoi pas, décliner les sigles français interminables :
/ANSES/
Agence nationale de sécurité sanitaire de l’alimentation de l’environnement et du travail
ou des abréviations fréquentes dans les publications médicales :
/<span\sclass=\"caps\">RR<\/span>/
risk reysho
/<span\sclass=\"caps\">OR<\/span>/
odd reysho
/<span\sclass=\"caps\">IC<\/span>/
intervalle de confiance a
On doit écrire « reysho » pour prononcer « ratio » à peu près comme en anglais… Ou, si l’on préfère, changer de langue :
/<span\sclass=\"caps\">RR<\/span>/
<voice name="en-GB-Wavenet-A">risk ratio</voice>
On commence à voir ici que l’interprétation, grâce aux règles de réécriture, peut s’approcher autant que souhaité d’un lecteur humain.
Corriger le français
De nombreuses règles apparaissent à l’usage (en écoutant les transcriptions vocales sur des pages entires), qui tiennent aux « trous dans la raquette » de l’apprentissage automatique.
Par exemple, si un mot ne figure pas dans le dictionnaire français, et si par contre il existe en anglais, le robot le prononcera à l’anglaise. C’est gênant pour certains mots qui ont migré de l’anglais vers le français et dont on a adapté la prononciation. Par exemple, « occurrence », qui n’est pas correct en français, bien que fréquemment employé aujourd’hui, est prononcé à l’anglaise… Pour s’en prémunir, il faut en modifier l’orthographe jusqu’à ce qu’une prononciation correcte soit réalisée. La solution est simple :
/occurence/
occurance
De même :
/urgents?/u
ûr jean
À l’inverse, le nom du journal « The Lancet » est prononcé de manière incompréhensible (si on ne bascule pas la langue vers l’anglais). Une solution est :
/The\sLancet/u
ze lent sept
On remarque ici qu’il faut toujours essayer de « donner à manger » des mots français pour qu’ils soient prononcé sans hésitation. Peu importe que le texte n’ait pas de sens : le TTS actuel n’analyse pas du tout le sens du texte — contrairement aux excellents traducteurs automatiques.
Certains mots se prononcent différemment selon le contexte, que le TTS français ne sait pas toujours identifier. C’est le cas de « fier » dont le “r” ne doit pas être prononcé s’il s’agit d’un verbe à l’infinitif. La règle suivante permet d’y remédier :
/([mts]e\s+)fier(\s+[aà])/u
$1fié$2
/([y]\s+)fier([^\p{L}])/u
$1fié$2
Avec cette règle, le “r” est prononcé ou inhibé correctement dans une expression comme : « On ne peut se fier à lui, se fier au temps, ne pas s’y fier, un fier à bras, ce fier à bras. »
Syllabes oubliées ou déformées
Dans certains cas, heureusement rares, le TTS francophone escamote des syllabes ou même des mots très courts à la fin d’une unité de souffle. Par exemple, « migrantes » suivi d’une virgule sera prononcé « migrants ». Pour éviter cela, on a besoin de règles spécifiques, par exemple :
/ante(s?)([^a-z])/u
anthe$1$2
Noter que le $1 capture le « s » du pluriel éventuel, ce qui permet d’effectuer la liaison si nécessaire.
Un autre défaut constaté est l’escamotage (occasionnel) de la dernière syllabe de mots tels que « nécrose », « cétose », etc. Il semble qu’il ait surtout lieu avec des mots d’au moins deux syllabes, ce qui exclut « chose ». La règle suivante permet d’y remédier :
/(\pL{3})ose([^\pL])/u
$1oze$2
La règle suivante empêche le TTS de prononcer à l’anglaise le verbe « perfuse » :
/([^a-z])perfuse([^a-z])/u
$1pairfûse$2
Sigles
Dans sa version actuelle, le TTS francophone gère assez bien la prononciation de sigles courants, somme « UNESCO » qui est prononcé « unèsko », ou « CIA » qui est épelé au lieu d’être prononcé « scia ». Mais l’automate prononce par exemple « ops » pour « OPS » au lieu de l’épeler. On a donc besoin, dans ce cas, de la règle :
/([^\p{L}])OPS([^\p{L}])/u
$1o p s$2
On voit ici apparaître l’expression « \pL » (ou « \p{L} ») qui désigne n’importe quel caractère Unicode représentant une lettre (majuscule ou minuscule). En effet, l’expression « [A‑Za‑z] » ne reconnaît pas des caractères comme le « é » de « nécrose ». L’expression « ^ \p{L} » désigne donc ici n’importe quel caractère autre qu’alphabétique.
Autre exemple de prononciation à corriger : le sigle « CRISPR » que la machine a tendance à épeler.
/CRISPR/u
crisp r
Bien entendu, certaines règles deviendront inutiles lorsque les automates TTS auront amélioré leur entraînement. Mais nous essuyons les plâtres !
Écriture inclusive
J’ai averti que les TTS ne savaient pas lire l’écriture inclusive. Toutefois, s’en tire pas trop mal si l’interprétation se résume à supprimer le point qui figure dans un mot, et que j’écris systématiquement « · » (option-majuscule‑f sur un clavier Mac) :
/·/u
Attention : la deuxième ligne est vide ! Avec cette règle, le mot « intelligent·e·s » sera lu comme « intelligentes ». Le féminin l’emporte, qui s’en plaindrait ? 😀
Une forme plus ancienne d’écriture inclusive est l’usage de parenthèses, par exemple dans l’expression « Tou(te)s les Français(es) ». Elle sera lue « Toutes ou tous les Françaises ou Français » en appliquant la règle suivante :
/([\s\[>“])(\pL+?)\((\pL+?)\)(\pL*?)([\.,\?!:;\s<”\)\]])/u
$1$2$3 ou $1$3$4
Les parenthèses (soulignées ici en rouge) servent à capturer les chaînes reproduites dans $1, $2, $3, $4 et $5.
Noter par exemple l’expression « [\s\[>“] » capturée dans $1 : ce sont tous les caractères qui peuvent précéder le premier mot. Il s’agit de l’espace, du crochet « [« , du signe « > » ou du guillemet anglais « “ ». Le signe « > » peut apparaître à la suite d’un élément « <em> », « <strong> », etc. Cette liste n’inclut pas le guillemet ouvrant français, car wp-Typography le convertit en ”&bsp ;”, donc suivi d’une espace.
Autre usage de parenthèses
La règle précédente ne permet pas de lire une expression comme « se (re)mettre au travail ». Alors qu’on avait accordé la primauté au féminin, donc la forme la plus longue, dans la règle précédente, il faut cette fois lire en second le contenu de la parenthèse, ce qui donne « se mettre ou remettre au travail ». On ajoute donc cette règle :
/([\s\[>“])\((\pL+?)\)(\pL+?)([\.,\?!:;\s<”\)\]])/u
$1$3 ou $2$3$4
Conversions code HTML vers Unicode
Pour que les exemples précédents fonctionnent, il faut au préalable avoir converti le « ç » et d’autres caractères étrangers à l’alphabet anglais, à partir de leur code HTML :
/ç/u
ç
Même nécessité pour toutes les autres lettres sujettes à un encodage HTML spécial :
/à/u
à
/â/u
â

etc.

/“/u
“
/”/u
”

etc.
Une fois ces conversions terminées, si l’on veut reconnaître toutes les lettres minuscules du français, on pourra utiliser l’expression « [a‑zàâçéèêëîïôûùüÿñæœ] ».
Signes non-alphabétiques
Des émoticônes figurent dans l’alphabet Unicode au sens large… On peut écrire quelques règles en les utilisant directement :
/⏱/u
 … image d'horloge —
Noter l’option « /u » qui est ici obligatoire.
Mais cela ne fonctionne jamais avec certains caractères, comme par exemple le rond bleu « 🔵 ». Dans ce cas, il faudra aller chercher la valeur de ce caractère en décimal : 128309.
Puis on programme une règle avec cette valeur :
/🔵/u
… c'est un rond bleu …
Les règles (RegEx replacements) sont appliquées une seule fois de haut en bas. Ce qui permet d’affiner certaines interprétations. Par exemple, on aimerait que le sigle « ™ » (marque commerciale, codé « &trade ; ») ne soit pas lu quand il figure à la fin d’un mot, mais qu’il soit explicité dans tout autre contexte. Deux règles suffisent à cela :
/([a-z])&trade/u
$1
/&trade/u
 signe de marque commerciale
Sur ce site, j’utilise un rond blanc pour marquer le début et la fin d’un extrait. Les règles suivantes le rendent explicite à la lecture :
/<p>\s*⚪️/u
 … Début d'extrait …
/⚪️\s*<\/p>/u
 … Fin d'extrait …
Ou, en utilisant les codes HTML numériques :
/<p>\s*⚪️/u … Début d'extrait … /⚪️\s*<\/p>/u … Fin d'extrait …
J’en viens à la règle très importante qui permet d’effacer tous les soft hyphens « ­ ; », à placer au sommet des RegEx replacements :
/­/u
(La deuxième ligne est vide.)
Où peut-on trouver les codes HTML numériques de ces caractères non-alphabétiques ? Tout simplement dans le fichier de trace fabriqué par (mon patch de) SPEAKER !
Un visage mécontent « 😣 » y apparaît par exemple comme « 😣 ; » qui permet de le placer dans la règle :
/😣/u
… (visage mécontent)…
Si l’on utilisait directement le caractère « 😣 » dans cette règle, l’ensemble des réécritures se planterait, ainsi que la conversion TTS… Sans qu’on en soit averti ! 😣😣😣
Corrections de typographie
Sans correction, une expression comme « […] avec l’Agence européenne du médicament […] » n’est pas prononcée correctement car les italiques sont remplacés par des chevrons avec espaces, ce qui donne :
[…] avec l'« Agence européenne du médicament » […]
Dans ce cas, la liaison entre « l” » et « Agence » n’est pas prononcée, et on entend « elle agence »… Pour corriger ce défaut il suffit d’ajouter la règle :
/([A-Za-z])'«\s*/u
« $1'
ce qui donne :
[…] avec « l'Agence européenne du médicament » […]
Unités de mesure
Il est important, pour lire des textes scientifiques, d’énoncer correctement les unités de mesure. Si le TTS francophone de Google Cloud traduit correctement « g/l » par « grammes par litre », il ne fonctionne pas avec toutes les combinaisons d’unités, comme par exemple « µg/dl » qui doit être lu « microgrammes par décilitre ». Le mieux est donc d’installer deux ensembles de règles, les premières pour les numérateurs et les secondes pour les dénominateurs. En voici un extrait.
Règles de numérateurs :
/\s+g\//u
 gramme/
/\s+dg\//u
 décigramme/
/\s+cg\//u
 centigramme/
Noter qu’on a bien préservé le « / » qui va servir de contexte aux règles de dénominateurs :
/\/[Kk]g([\.,\?!:;\s<\)\]\/])/u
 par kilogramme$1
/\/g([\.,\?!:;\s<\)\]\/])/u
 par gramme$1
/\/m[Ll]([\.,\?!:;\s<\)\]\/])/u
 par millilitre$1
/\/c[Ll]([\.,\?!:;\s<\)\]\/])/u
 par centilitre$1
/\/d[Ll]([\.,\?!:;\s<\)\]\/])/u
 par décilitre$1
À noter, l’expression « [\.,\?!:;\s<\)\]\/] » qui représente n’importe quel caractère pouvant apparaître après une unité de mesure.
Pour le symbole du litre, on a admis ici que les deux abréviations « l » et « L » sont acceptables, d’où l’expression « [Ll] ».
Il faut aussi tenir compte des exposants, par exemple dans « 9.81 m/s2« . Pour cela, la règle du dénominateur sera :
/\/s<sup>2<\/sup>/u
 par seconde au carré
Meme chose pour les autres puissances.
Cette méthode fonctionne avec des unités plus complexes, par exemple pour dire « 15 mg/kg/h ».
De nombreux bricolages avec les chiffres sont possibles. On souhaite par exemple que « 15h25 » soit lu « quinze heures vingt-cinq » plutôt que « quinze hache vingt-cinq », mais que « 17h00 » soit simplement lu « dix-sept heures » Les règles suivantes sont suffisantes :
/([0-9]{1,2})h00/u
$1 heure
/([0-9]{1,2})h([0-9]{0,2})/u
$1 heure $2
Liaisons
Actuellement (début 2023), les voix françaises sot peu fiables au niveau des liaisons. Plus précisément, elles oublient des liaisons qui seraient fortement recommandées dans un style d’élocution « académique »… Il est donc nécessaire de les programmer.
Le traitement de ces liaisons oblige à passer par des variables intermédiaires. J’utilise ZZ”, TT”, NN” et PP” pour marquer une liaison, avec des règles finales qui les remplacent par des caractères familiers au TTS :
/ZZ'/u
z'
/NN'/u
n'
/PP'/u
p'
/TT'/u
t'
Par exemple, pour lire « les beaux arbres », la règle suivante a été appliquée :
/([eau]xz)\s+([aàeéèêiîouyh])/u
$1 ZZ'$2
ce qui donnera dans un premier temps « les beaux ZZ’arbres », puis en fin de traitement « les beaux z’arbres ».
Cet exemple n’est pas forcément pertinent, car la plupart des voix produisent déjà la liaison correcte. Il faut éviter de créer des liaisons là où elles auraient été créées automatiquement, car l’ajout de code (exemple « ils z’avaient ») altère parfois le profil prosodique de la phrase, créant des accentuations peu réalistes.
La méthode est donc plus compliquée, car les règles de liaison sont contextuelles, et les exceptions nombreuses. Pour les mettre au point, il faut écouter les versions orales d’à peu près toutes les pages et articles du site. Pour éviter une facturation excessive de TTS, on peut rassembler les points litigieux dans un petit texte « bac à sable » sur lequel on vérifie le bon fonctionnement de la transcription orale.
Par exemple, les expressions « nous z’avons », « vous z’avez » ou « les z’ans » ont un très mauvais rendu en TTS. Il faut donc ajouter des règles comme :
/ZZ'avez/u
zavés
/ZZ'avons/u
zavons
/ZZ'an/u
zan
Le « s » de « zavés » est indispensable car le TTS prononcerait « z’avé » comme « z a vé é accent aigu » ! Il a tendance à épeler les mots courts qui ne sont pas dans son dictionnaire — ou plutôt, le dictionnaire invisible qu’il a construit dans ses « neurones ». Le plus simple est peut-être de s’inspirer du langage SMS…
Les apostrophes produites par les règles de liaisons peuvent aussi déformer de manière insatisfaisante le contour prosodique. C’est pourquoi « zavons » est d’un meilleur rendu que « z’avons ».
Il faut forcer la liaison dans des expressions comme « prêt-à-penser » ou « prêt‑à porter » qui sont mal lues par le TTS. Cette règle corrige l’erreur :
/prêt\-à/u
prêt ta
On a aussi besoin de règles d’effacement. Par exemple, pour éviter d’entendre « des z’hauteurs » ou « des z’haubans », on ajoute la règle :
/ZZ'hau/u
hau
On peut enfin, par sécurité, effacer toutes les liaisons produites accidentellement par d’autres règles mal configurées :
/TT'([bcdfgjklmnpqrstvwxz])/u
$1
/NN'([bcdfgjklmnpqrstvwxz])/u
$1
/ZZ'([bcdfgjklmnpqrstvwxz])/u
$1
/PP'([bcdfgjklmnpqrstvwxz])/u
$1
/TT'([\d\.,\?!:;\s<\)\]])/u
$1
/NN'([\d\.,\?!:;\s<\)\]])/u
$1
/ZZ'([\d\.,\?!:;\s<\)\]])/u
$1
/PP'([\d\.,\?!:;\s<\)\]])/u
$1
Le symbole « \d » représente ici un chiffre. Il est équivalent à « [0–9] » que j’ai tendance à préférer car il est plus explicite.
Les liaisons contraintes par des règles peuvent entraîner la mauvaise prononciation de mots courts dont la prononciation est alors, soit empruntée à l’anglais, soit simplement épelée. Par exemple, la conversion de « vous avez eu » en « vous z’avez z’eu » ne donne pas un son correct. Le résultat est obtenu avec « vous zavés z’û ». On a appliqué ici la séquence de règles (plus générales) suivantes :
/([eau]xz)\s+([aàeéèêiîouyh])/u (appliquée 2 fois)
$1 ZZ'$2
/ZZ'avez/u (appliquée 1 fois)
zavés
/([\s'])eue?s?([\.,\?!:;\s<\)\]])/u (appliquée 1 fois)
$1û$2
/ZZ'/u (appliquée 2 fois)
z'
On devine ici que l’ordre des règles (RegEx replacements) est critique dans cette grammaire formelle. On le corrige en écoutant de nombreux exemples…
Titres et légendes
Pour annoncer les titres, on peut utiliser des règles du style :
/<h1[^>]*>/u
<break time="1s" strength="none"></break>Titre de niveau 1… …
/<h2[^>]*>/u
<break time="1s" strength="none"></break>Titre de niveau 2… …
/<\/h1>/u
… … <break time="1s" strength="none"></break>
/<\/h2>/u
… … <break time="1s" strength="none"></break>
La question des légendes de figures est plus délicate. Il est utile de lire les légendes et de les déclarer comme légendes, sauf si elles sont vides. D’autre part, une légende comme « Source : … » n’est pas utile en lecture. Les règles que j’utilise, et que les experts de RegEx comprendront sans difficulté, sont les suivantes :
/<img\s[^\/]*?\/>/u

/<img\s.*?>/u

/<iframe\s[^<]+?<\/iframe>/u

/<span\sclass=\"caption\-text\">(.*?)<\/span>/u
$1
/<figure\s[^>]*?>(.*?)<\/figure>/u
$1
/<figcaption[^>]*?>\s*Source.+?<\/figcaption>/u

/<figcaption[^>]*?>\s*?<\/figcaption>/u

/<figcaption[^>]*?>(.+?)<\/figcaption>/u
… Image avec légende « $1 » (fin de légende)… <p>…</p>
La séquence « <p>…</p> » sur la dernière règle est un autre moyen de ménager une courte pause sans affecter le contour prosodique.
Ces règles sont compatibles, sur ce site, avec l’utilisation des plugins wp-Typography pour les textes et Optimole pour les images. Pour les adapter à d’autres configurations, il faut analyser avec soin le rendu de la page, en mode « code » sur le navigateur, qui est plus détaillé que le mode « code » dans l’éditeur de WordPress, car il intègre des annotations typographiques.
Changement de voix ou de langue
Pour la traduction de phrases ou d’expressions en d’autres langues, je ne recommande pas d’insérer chaque fois l’expression SSML complète. Non seulement c’est fastidieux, avec un risque d’erreur, mais par ailleurs on peut souhaiter par la suite choisir une voix nouvelle pour la langue concernée.
Le plus simple est de déclarer la langue (et le genre) dans une classe CSS. Par exemple :
Le <em class="male-en">Handbook of Nutritional Value of Foods in Common Units</em>
si l’expression est en italiques, ou simplement, sans les italiques :
Le <span class="male-en">Handbook of Nutritional Value of Foods in Common Units</span>
On utilise ensuite les règles suivantes, par exemple pour l’anglais, l’allemand, l’italien et l’espagnol au masculin et au féminin. Ces règles modifient la voix/langue tout en ajustant la vitesse d’élocution pour compenser la modification globale programmée dans la langue principale. Pour le français, on a choisi d’augmenter de 20 % la vitesse. Par conséquent, pour les langues étrangères on la diminue de 20 %, ce qui donne :
/<[^\s]+?\s+class=\"male\-en\"\s*>(.+?)<\/[^>]+?>/u
<voice name="en-GB-News-J"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"female\-en\"\s*>(.+?)<\/[^>]+?>/u
<voice name="en-GB-News-I"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"male\-de\"\s*>(.+?)<\/[^>]+?>/u
<voice name="de-DE-Wavenet-B"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"female\-de\"\s*>(.+?)<\/[^>]+?>/u
<voice name="de-DE-Wavenet-C"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"male\-it\"\s*>(.+?)<\/[^>]+?>/u
<voice name="it-IT-Standard-D"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"female\-it"\s*>(.+?)<\/[^>]+?>/u
<voice name="it-IT-Standard-B"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"male\-es\"\s*>(.+?)<\/[^>]+?>/u
<voice name="es-ES-Neural2-F"><prosody rate="80%">$1</prosody></voice>
/<[^\s]+?\s+class=\"female\-es"\s*>(.+?)<\/[^>]+?>/u
<voice name="es-ES-Neural2-E"><prosody rate="80%">$1</prosody></voice>
➡ Les changements de vitesse d’élocution n’ont pas encore été appliqués à tous les articles du site.
Un avantage de disposer de deux règles uniques (mâle-femelle) pour chaque langue est qu’il suffira de modifier une seule de ces règles si l’on choisit une autre voix, sans avoir à corriger les textes des pages ou articles concernés.
Attention : cette méthode ne fonctionne que si la classe (« male-en » etc.) est attribuée à l’élément HTML le plus proche du texte. Concrètement, elle ne fonctionnerait pas ici :
Le <em class="male-en"><strong>Handbook of Nutritional Value of Foods in Common Units</strong></em>
Il faudrait corriger le texte ainsi :
Le <em><strong class="male-en">Handbook of Nutritional Value of Foods in Common Units</strong></em>
Un inconvénient de la version actuelle de SPEAKER (4.0.13) est que le même ensemble de règles s’applique à toutes les langues utilisées sur une page ou un article, de sorte que des liaisons dangereuses pourraient être imposées aux textes en langues étrangères… On peut partiellement les neutraliser, je ne l’expliquerai pas ici. J’ai signalé ce problème dans mon rapport, et l’équipe technique a annoncé qu’elle prévoyait dans une prochaine version la gestion de règles spécifiques aux voix/langues.
Citations
J’ai programmé des règles pour que les contenus de citations soient lus avec une voix différente de celle du texte principal :
/<blockquote[^>]*>/u
<voice name="fr-FR-Wavenet-C"> … Début de citation…
/<\/blockquote>/u
</voice> Fin de citation…
Ça fonctionne tant que SPEAKER ne trouve pas un élément « </p> » dans la citation. En effet, il peut utiliser cet élément pour fragmenter le texte (dans la limite de 4500 caractères), auquel cas les fragments suivants reviennent à la voix/langue par défaut.
La solution la plus simple est de supprimer les « </p><p> » dans les citations, ce qui n’est apparemment pas faisable automatiquement, mais qui impose de remplacer les marques de paragraphes par de simples sauts de ligne dans chaque citation.
Regardons pour cela la page WordPress en mode « code ». Au lieu d’écrire :
<!-- wp:quote {"extUtilities":[]} -->
<blockquote class="wp-block-quote"><!-- wp:paragraph -->
<p>Blah blah 1</p>
<!-- /wp:paragraph -->
<!-- wp:paragraph -->
<p>Blah blah 2</p>
<!-- /wp:paragraph --></blockquote>
<!-- /wp:quote -->
on écrira :
<!-- wp:quote {"extUtilities":[]} -->
<blockquote class="wp-block-quote"><!-- wp:paragraph -->
<p>Blah blah 1<br><br>Blah blah 2</p>
<!-- /wp:paragraph --></blockquote>
<!-- /wp:quote -->
Cette solution fonctionne bien, sauf qu’elle peut produire des fragments de texte supérieurs aux 4500 caractères autorisés par Google Cloud. Ma version patchée de SPEAKER avertit l’utilisateur : à lui/elle de s’arranger pour scinder la citation en plusieurs morceaux si elle est trop longue.
Un autre défaut de cette méthode de changement de voix dans les citations apparaît lorsqu’une expression en langue étrangère figure dans une citation. Le changement de voix/langue se fera correctement pour l’énoncer, mais ensuite le système reviendra à la voix d’origine, au lieu de celle prévue pour les citations. Ce problème est résolu en ajoutant une expression (invisible) qui force le retour à la voix de citation, par exemple :
Le <em class="female-en"><strong>Handbook of Nutritional Value of Foods in Common Units</strong></em><span class="citation"></span>
La correction de voix sera assurée par la règle :
/<span\s+class=\"citation\">[^<]*?<\/span>/u
<voice name="fr-FR-Wavenet-C">
On note ici qu’il n’est pas gênant de ne pas avoir d’élément « </voice> » à la fin d’un fragment de texte. SPEAKER se débarrasse en fait des éléments « <voice> » en les remplaçant par des paramètres transmis à Google Cloud avec chaque fragment de texte.
Conclusion
Tot ce qui précède s’applique à l’utilisation de voix francophones Google Cloud au stade de développement de début 2023. Il est raisonnable d’espérer que des voix plus entraînées verront le jour, qui permettront de se passer d’un grand nombre de règles — notamment pour les liaisons en français.

 Partager
